 Đăng nhập bằng Google
 Đăng nhập bằng Facebook



 Tiếng việt
 English



Mô hình AI hiểu ngữ cảnh tiếng Việt — trích xuất thông tin chính xác
 15
 0
 Bạn
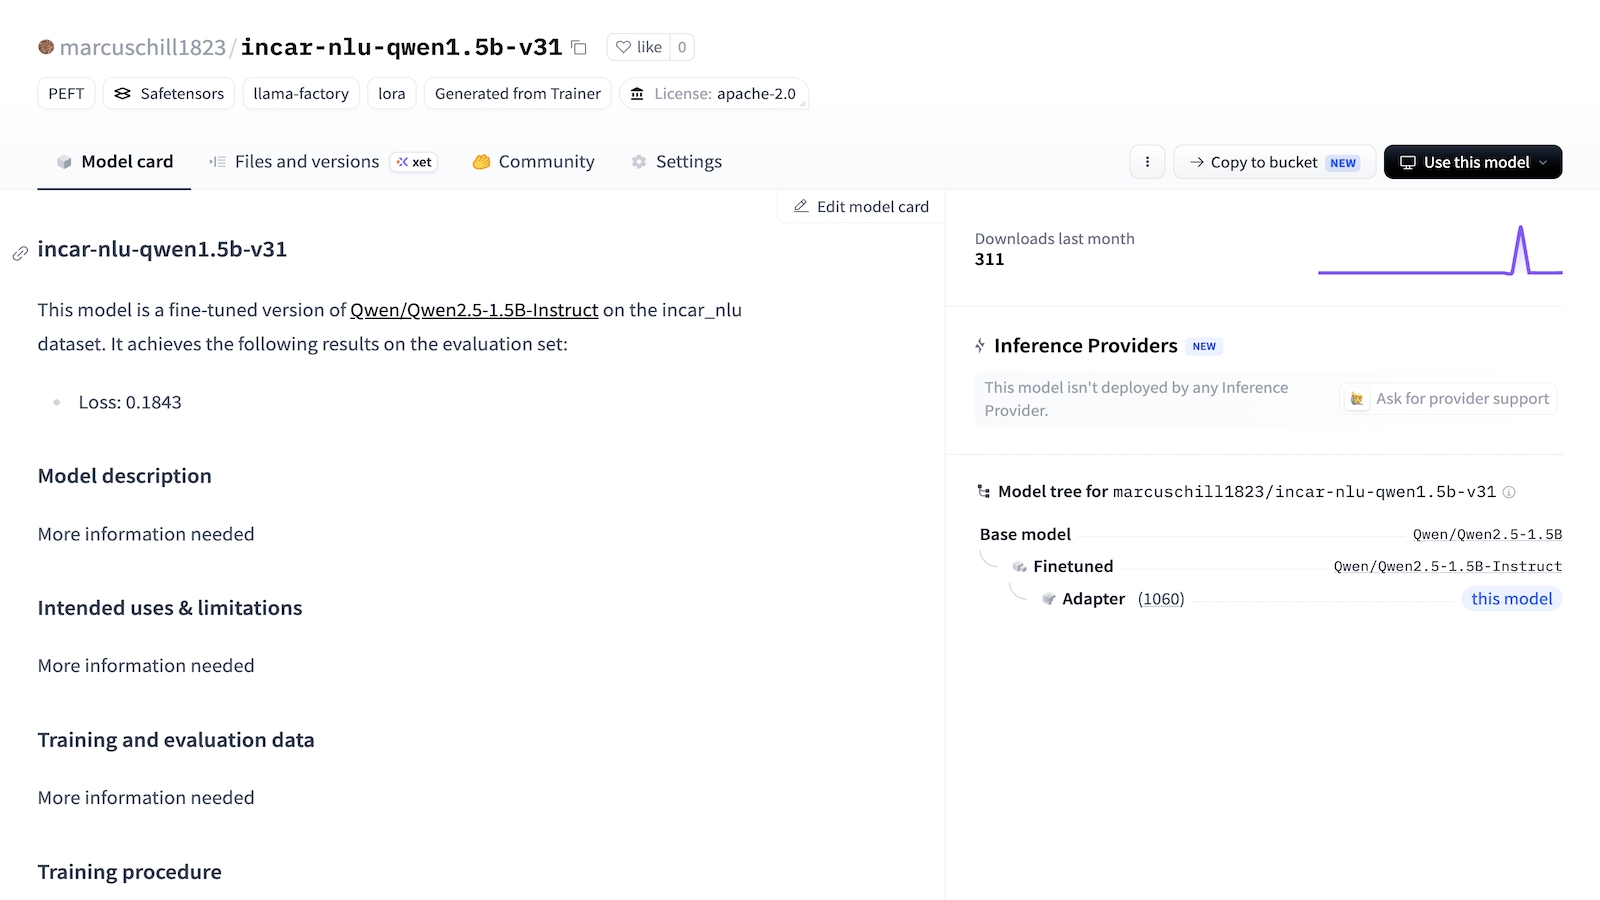


Tôi tự huấn luyện một mô hình AI 1.5B tham số chuyên đọc hiểu và trích xuất thông tin từ tiếng Việt theo đúng ngữ cảnh hội thoại — thứ mà các công cụ nước ngoài thường làm sai vì không nắm được đặc thù tiếng Việt.
Bài toán khó nhất tôi giải quyết: làm sao để AI hiểu đúng ý người dùng theo ngữ cảnh. Ví dụ khi người dùng nói "đổ đầy bình", mô hình phải tự suy ra được địa điểm đã nhắc trước đó; nhưng với câu "mở nhạc đi" thì tuyệt đối không được gán nhầm thông tin thừa vào. Đây chính là ranh giới giữa một AI hiểu ngữ cảnh thật và một AI máy móc gây lỗi.
Để đạt được điều này, tôi thiết kế một chiến lược tạo dữ liệu huấn luyện riêng, ép mô hình học đúng quan hệ giữa thông tin và ngữ cảnh thay vì đoán mò theo bề mặt. Tôi xử lý trọn quy trình: chuẩn bị dữ liệu, huấn luyện bằng kỹ thuật LoRA, đánh giá bằng nhiều chỉ số và tối ưu để chạy với chi phí thấp, có thể tự triển khai trên hạ tầng riêng.
Điều này có ý nghĩa gì với bạn: nếu doanh nghiệp của bạn cần xử lý lượng lớn văn bản, hội thoại hay giấy tờ tiếng Việt — bóc tách CV, đọc hồ sơ, phân loại nội dung, làm trợ lý ảo hiểu khách hàng — tôi xây được mô hình chính xác hơn hẳn các giải pháp ngoại, và chạy với chi phí bạn kiểm soát được.

Top hồ sơ nổi bật
Portfolio
minh nhat
Thiết kế web
minh nhat
Social AI Chatbot Integration
Nguyễn Hoàng Anh
Quảng cáo